网站适配
type: "site",文件 site.json。绝大多数网站,扉阅自己就找得到正文。有的网站页面结构特别,评论区、推荐阅读、订阅栏混在文章旁边,才需要你告诉它:正文在哪,哪里别管。
能改什么
小节标题“能改什么”- 哪些网站(
hosts):写域名,*.开头能匹配所有子域名。 - 正文在哪几块(
main):写了就只管这几块里的句子。 - 哪几块别管(
skip):评论区、广告这类。在别管的地方按 ⌘C,就是普通的复制。 - 只管哪几种网址(
paths,格式 1.2):/news/*这样写,*是任意一截;不写是整个网站。同一个网站的文章页、专栏页结构不同,可以各写一条。 - 读句子时拿掉的小东西(
drop,格式 1.2):脚注号、“阅读更多”、句子中间插的广告词。拿掉以后句子读起来是连着的。 - 别看网页标的语言(
english,格式 1.2):有的网站把英文正文标成别的语言、或者夹着中文注释,写true就按字母算:英文字母过半就当英文。
小例子
小节标题“小例子”样例 site-demo:一个示例新闻站,正文在 article .story-body,评论区、推荐阅读、订阅栏别管。
{ "sites": [ { "hosts": ["news.example.org", "*.news.example.org"], "main": ["article .story-body"], "skip": [".comments", "aside.related", "[data-role='newsletter']"] } ]}在哪里看到
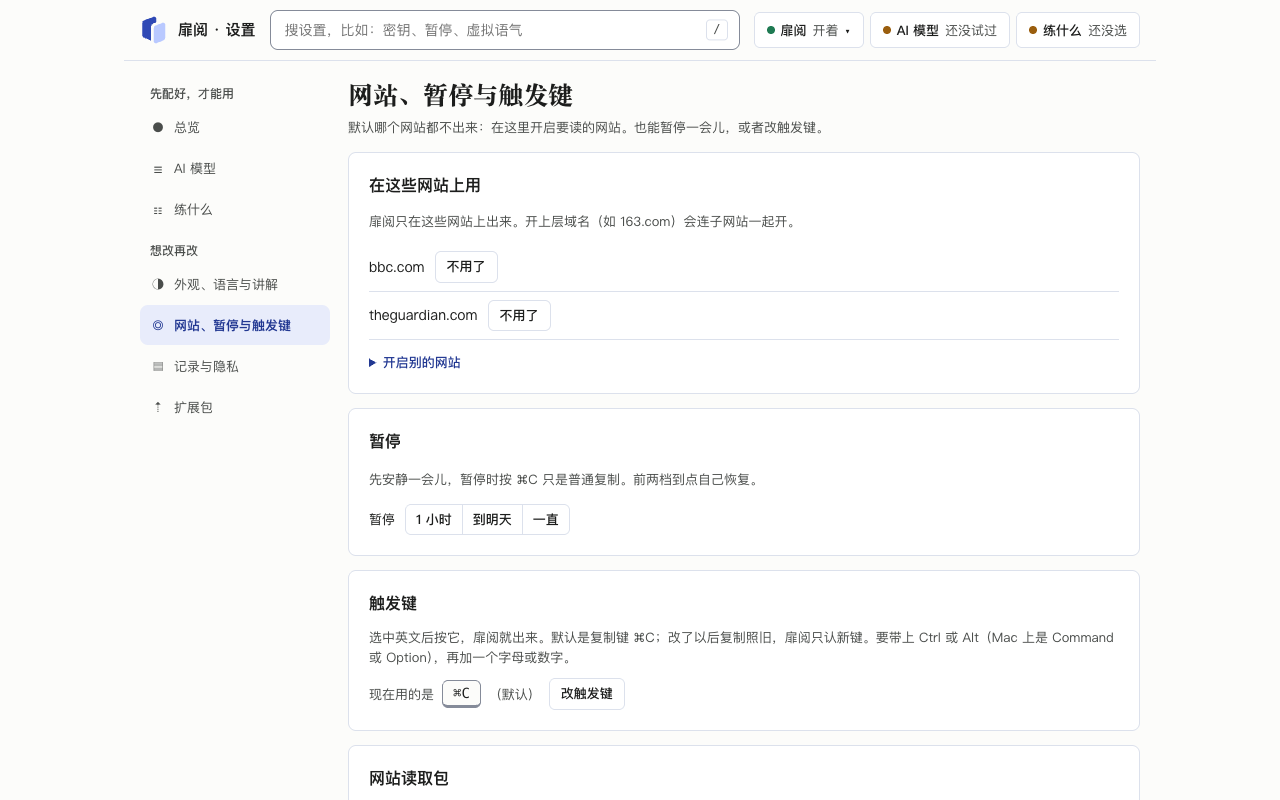
小节标题“在哪里看到”设置页“网站、暂停与触发键”页的“网站读取包”里列出每一条,装了就用,用户能一条一条关掉。
改不了什么
小节标题“改不了什么”- 它只是找网页上的块:选择器里不许有
url()、花括号、分号、尖括号、@,每条最长 200 字;反斜杠只用来转义类名里的特殊字符(.md\:flex这类)。 - 不能强制扉阅在不该出手的地方出手,也不能替读者把哪个网站关掉、打开:开哪几个网站是读者自己的事。
- 输入框、代码块、标明不是英文的段落,扉阅本来就不管,网站适配改不了这一条。