评测句集
type: "cases"。扉阅的每一步(画结构图、找主干、找语法点等)都靠你自己配的模型来做。换了模型、改了提示词,做得到底怎么样?评测句集就是一批自己写的、带标准答案的句子,拿来给某一步打分。
能改什么
小节标题“能改什么”- 这批句子给哪一步用(
cases.json的for):可以写任务名、语法包的 id,或某个语法点的完整名字。 - 句子从哪来(
source,必须写,≤ 80 字):说明是自己写的,还是公版的。 - 句子本身(
cases.jsonl):一行一句,带标准答案。发布前至少 10 句,要自己新写。
小例子
小节标题“小例子”样例 cases-demo:十句自己写的长句,给“画整句结构”那一步,每句写了主干。
{ "for": "structure", "source": "SDK 样例自己写的句子,没有从别处抄" }// cases.jsonl 里的一行{"id": "demo:harbour", "sentence": "The harbour, which had been closed for three weeks after the storm, finally reopened on Monday.", "expect": {"trunk": "The harbour reopened"}}在哪里看到
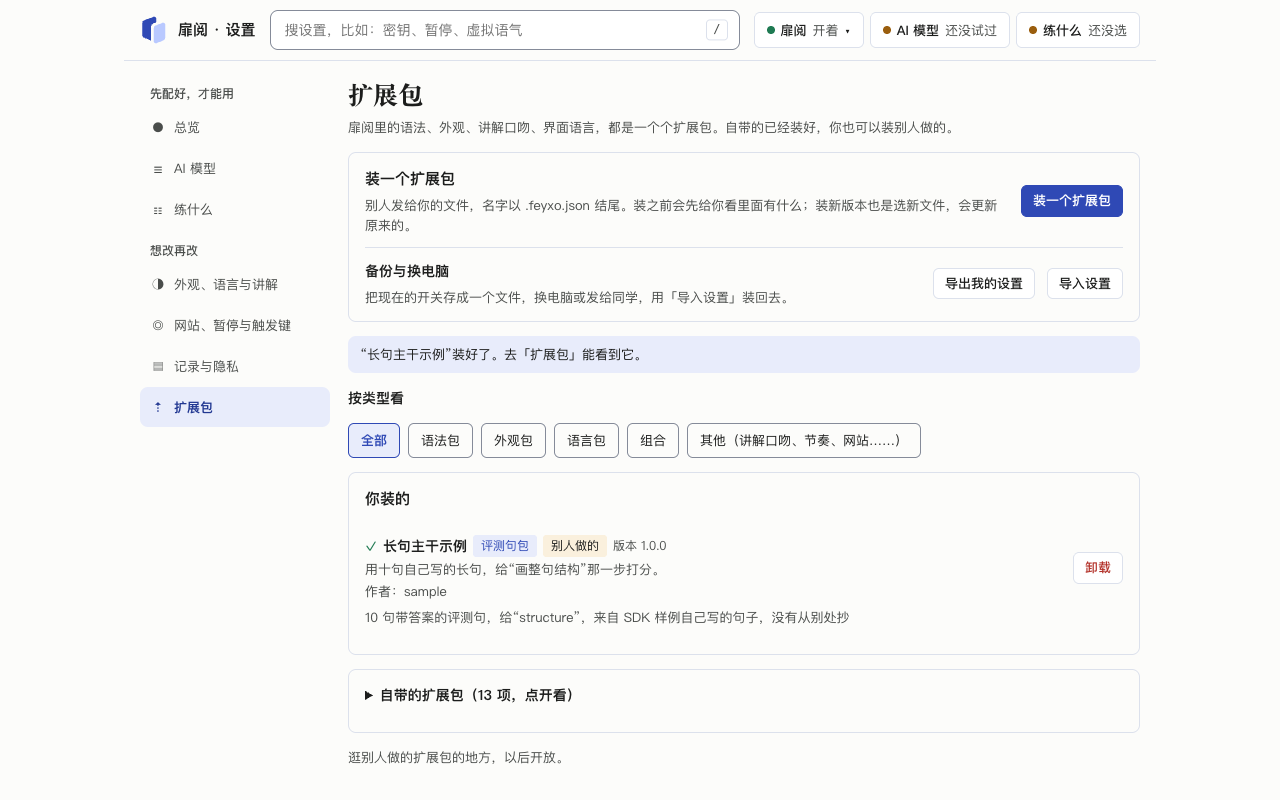
小节标题“在哪里看到”- 设置页“扩展包”里已装的那一行:写着有几句、给哪一步。
- 在你自己的电脑上用
feyxo try,拿你配的模型把这批句子跑一遍,看成绩。
改不了什么
小节标题“改不了什么”- “用我的模型试一试这个语法点”也读它,但只读指向语法点的。
for写语法点的完整名字(或语法包 id)时,这批句子会加进那个语法点自己带的评测句里一起试;for写任务名的,设置页只列出来,不跑。 - 评测句集不会改变扉阅怎么做题,它只是一张“考卷”。